

olmOCR 是一个开源工具,旨在将 PDF 和其他基于图像的文档格式转换为干净、可读的纯文本格式。它支持将 PDF、PNG 和 JPEG 格式的文档转换为 Markdown 格式,并支持方程式、表格、手写内容和复杂格式的处理。该工具还具备自动去除页眉和页脚、保持文本自然阅读顺序等功能,即使在存在图表、多列布局和嵌入内容的情况下也能有效处理。
- olmOCR开源项目地址:https://github.com/allenai/olmocr
- olmOCR官网入口网址:https://olmocr.allenai.org/
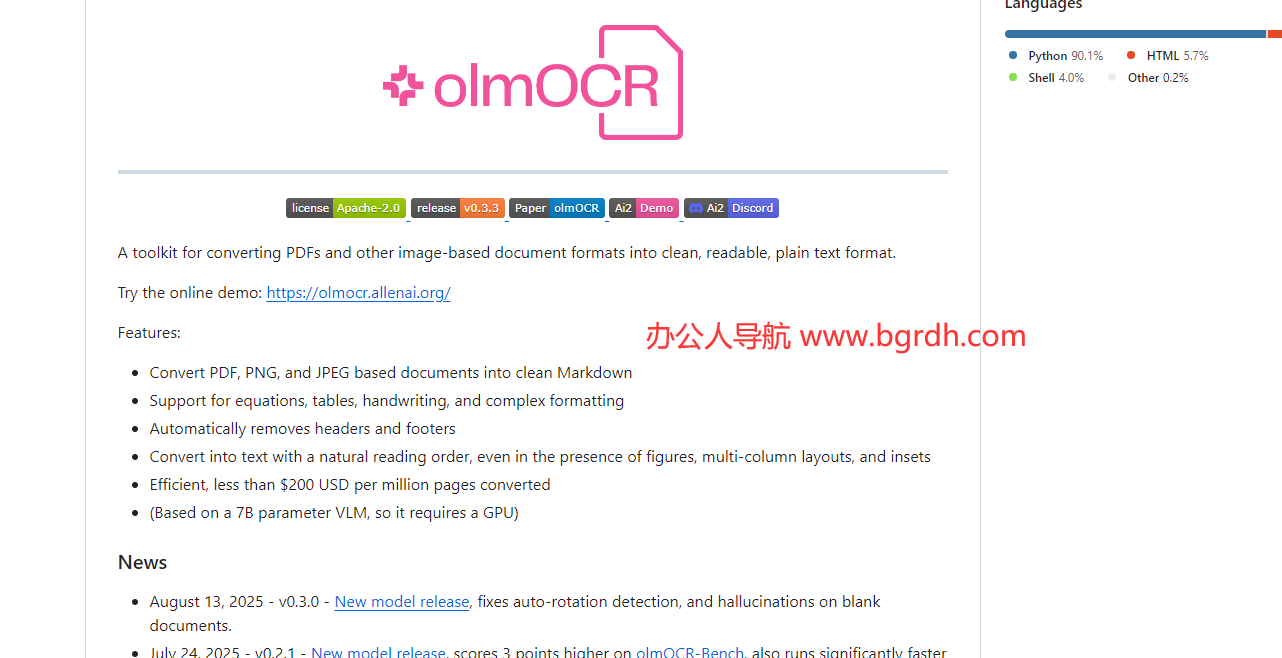
olmOCR 基于 7B 参数的视觉语言模型(VLM),需要 GPU 支持,且每百万页的转换成本低于 200 美元。该工具由 Allen Institute for Artificial Intelligence(AI2)开发和维护,旨在通过高影响力的人工智能研究和工程推动人类进步。
用户可以通过在线演示(https://olmocr.allenai.org/ )尝试使用该工具。此外,olmOCR 提供了详细的安装指南、命令行工具和 API 支持,适用于本地运行和大规模处理。该工具还提供了详细的性能基准测试和模型评估,以确保其在 OCR 领域的领先地位。
olmOCR 是一个功能强大且灵活的工具,适用于需要将图像和 PDF 文档转换为可读文本的用户和研究人员。

