Stable Diffusion是一种先进的图像生成技术,结合了扩散过程、变分自编码器和可逆网络等关键技术。它属于潜在扩散模型(Latent Diffusion Model),通过在潜在表示空间中迭代“去噪”数据来生成图像。该模型的核心思想是利用文本中包含的分布信息作为指导,逐步将一张纯噪声的图片去噪,生成与文本信息匹配的图像。
- Stable Diffusion官网网址:https://stability.ai/
- Stable Diffusion项目地址:https://github.com/CompVis/stable-diffusion
- Stable Diffusion维基百科介绍:https://zh.wikipedia.org/wiki/Stable_Diffusion
- Stable Diffusion官方在线版SD:https://beta.dreamstudio.ai/generate
- Stable Diffusion官方论坛:https://discord.com/invite/stablediffusion
此站可能需要科学上网,无法访问的同学是因为被限制访问的问题。
使用百度或国内其他搜索工具搜索“Stable Diffusion官网”,出现的结果都并非真正的Stable Diffusion官网,大家可以通过维基百科或者谷歌搜索获取Stable Diffusion官网网址。
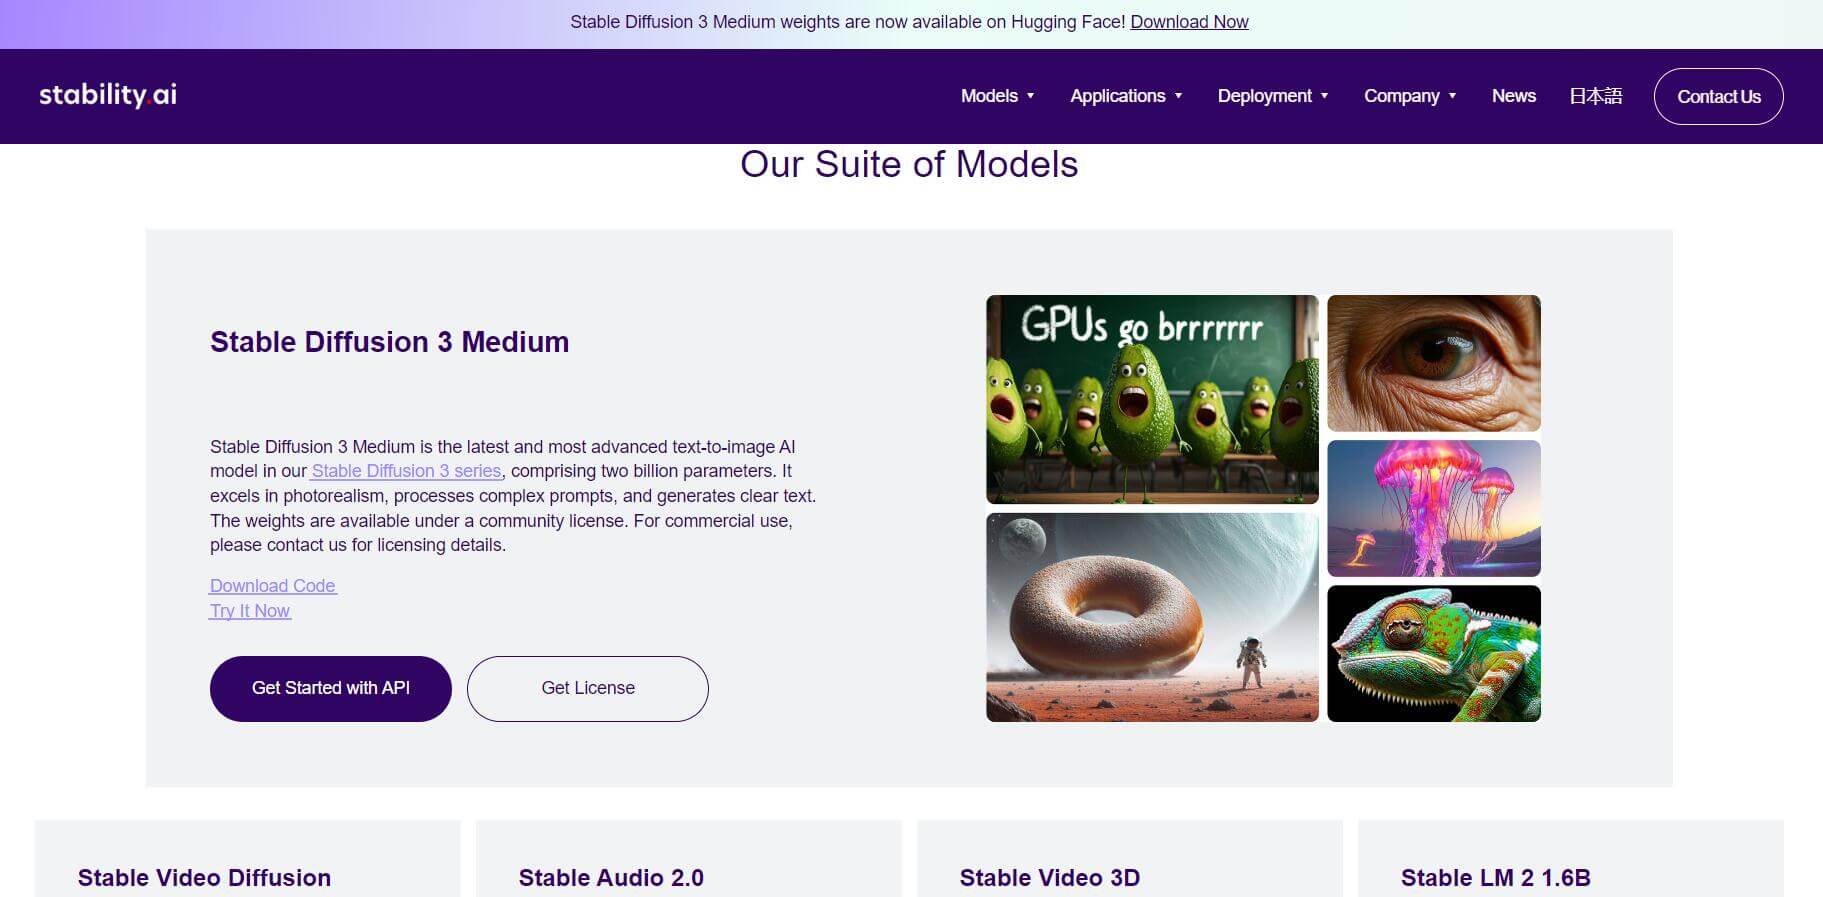
Stable Diffusion的发展可以追溯到2010年代初,当时研究人员开始探索使用扩散模型进行图像生成。其早期发展主要集中在基于概率论的生成模型上。近年来,随着计算资源的支持和大规模数据集的训练,Stable Diffusion在图像生成领域取得了显著进展。
Stable Diffusion的应用非常广泛,包括但不限于图像去噪、图像平滑、图像增强以及根据文本提示生成高质量图像。例如,在商业领域,阿里云基于Stable Diffusion开发了大规模底模切换和大量LoRA调优的技术架构,并已实现部署交付,稳定运行。此外,Stable Diffusion还被应用于艺术创作、设计和市场营销等领域,帮助创作者提高内容创作效率。
Stable Diffusion作为一种前沿的图像生成技术,不仅在学术研究中取得了重要进展,也在实际应用中展现了巨大的潜力和价值。