紫东太初是中国科学院自动化研究所和武汉人工智能研究院推出新一代多模态大模型,支持多轮问答、文本创作、图像生成、3D理解、信号分析等全面问答任务,拥有更强的认知、理解、创作能力,带来全新互动体验。
紫东太初官网网址:https://taichu-web.ia.ac.cn/
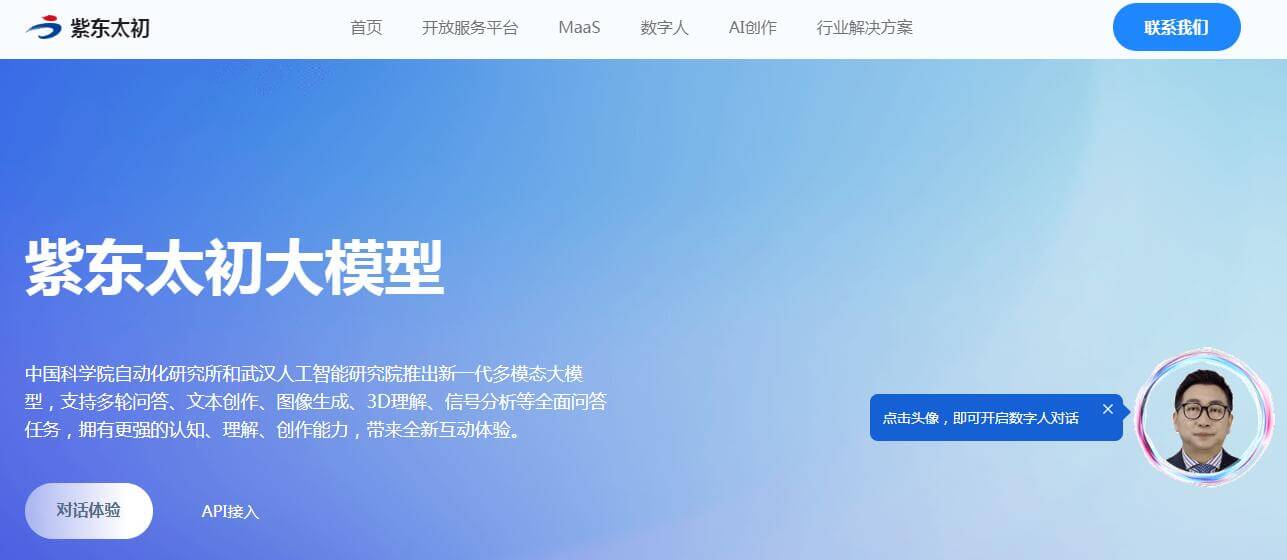
“紫东太初”是由中国科学院自动化研究所和武汉人工智能研究院联合研发的全球首个千亿参数三模态大模型,主要由图像、文本和语音三种模态数据组成。该模型实现了图像、文本、语音三模态数据之间的“统一表示”与“相互生成”,并具备跨模态理解和生成能力。此外,紫东太初还支持视频、信号、3D点云等多种模态数据,进一步提升了其全模态理解能力和生成能力。
紫东太初基于昇思MindSpore框架,采用自监督学习方法来贯通不同模态的数据关系,具有强大的多任务泛化能力。
紫东太初大模型开放服务平台提供了全模态数据的认知、理解、创作服务,旨在让人工智能更智能、更贴近人类。该平台支持多轮问答、文本创作、图像生成、3D理解、信号分析等全面问答任务,拥有更强的认知、理解和创作能力。
紫东太初是一个跨模态通用人工智能平台,通过整合多种模态数据,推动了通用人工智能的发展,并在多个领域展现出广泛的应用前景。