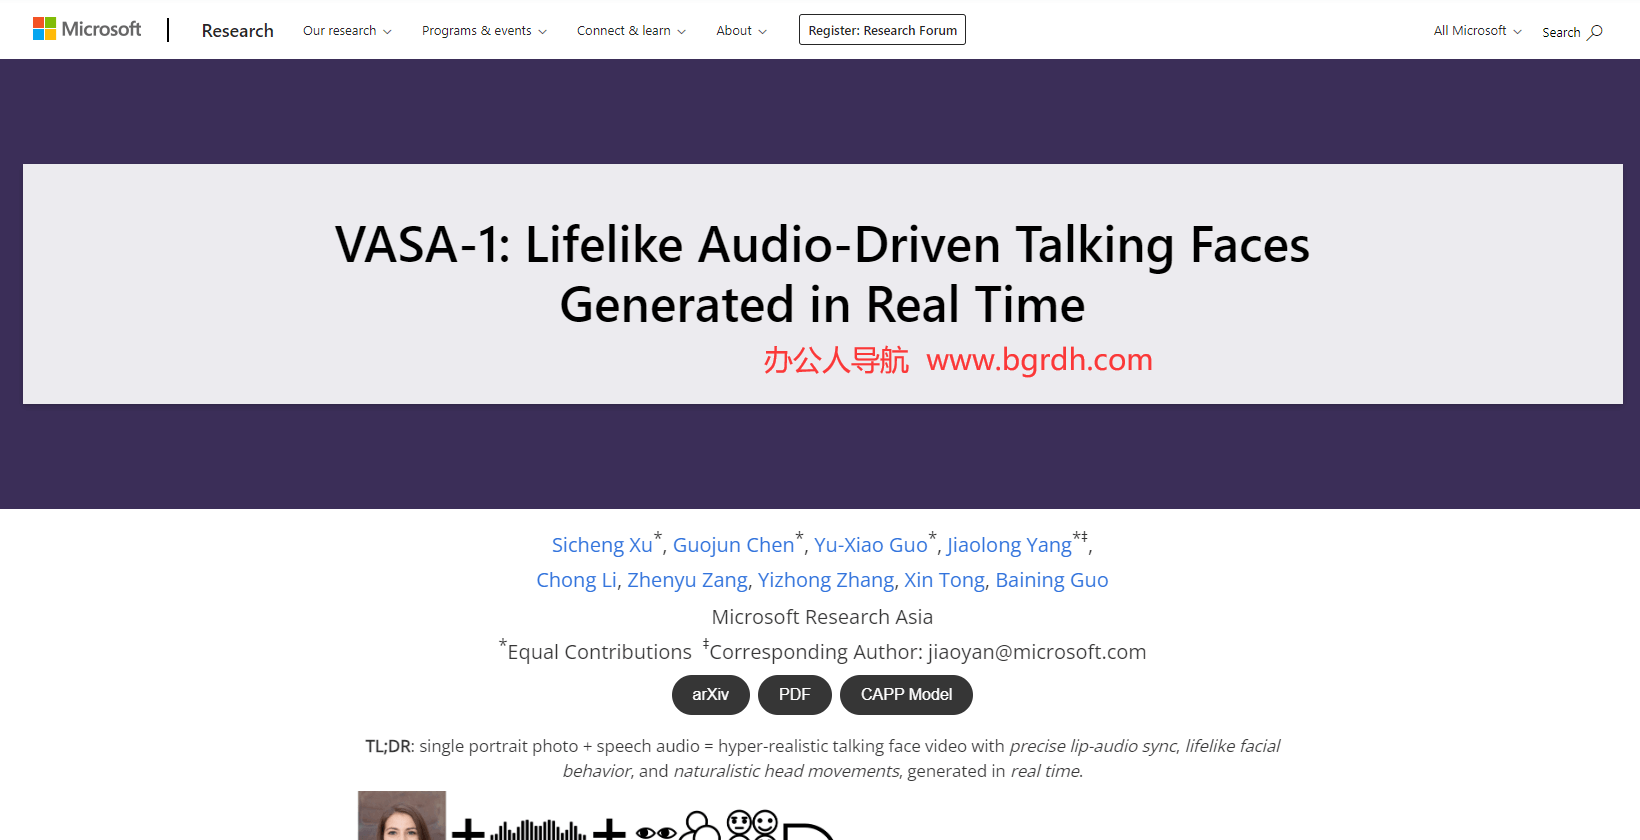
VASA-1 是微软亚洲研究院开发的一款革命性的 AI 模型,能够将静态照片和音频文件结合生成逼真的说话视频。这项技术通过深度学习和计算机视觉技术,实现了高质量的面部表情、唇动同步以及自然的头部动作生成。
VASA-1官网入口网址:https://www.microsoft.com/en-us/research/project/vasa-1/
VASA-1 的核心功能包括:
- 音视频同步:该模型能够精确地将输入的音频与面部表情和唇动同步,生成逼真的说话效果。这使得生成的视频看起来非常真实,仿佛是真人正在说话。
- 面部动态捕捉:VASA-1 能够捕捉到细微的面部表情和自然的头部动作,从而增强视频的真实感和生动性。 实时生成:该模型支持实时生成高质量的视频内容,延迟极低,适合在线直播等应用场景。
- 解耦控制:VASA-1 允许用户独立控制面部特征(如眼睛、嘴巴、头部动作),并根据需要调整表情和情感表达。
VASA-1 的应用场景非常广泛,包括虚拟主播、在线教育、社交媒体、影视制作等领域。例如,在虚拟主播领域,VASA-1 可以将静态照片转化为动态的虚拟主播形象,提升直播的互动性和沉浸感;在影视制作中,VASA-1 可以用于创建逼真的 AI 角色,帮助实现更加生动的视觉效果。
然而,VASA-1 的强大功能也带来了潜在的风险,例如可能被用于制作深度伪造视频,从而对社会造成不良影响。因此,微软在开发过程中特别注重负责任的 AI 使用,并采取了相应的措施来确保生成内容的透明度和合规性。
VASA-1 是一项具有突破性的 AI 技术,它不仅展示了 AI 在视频生成领域的巨大潜力,也为未来的虚拟现实和人工智能应用开辟了新的可能性。