浪潮海若大模型是浪潮云推出的一款行业大模型产品。该模型定位为行业大模型市场,面向政府、交通、能源、医疗、司法、智能制造等六大行业,具备生成创作、多轮对话、逻辑推理等多项核心能力。
浪潮海若大模型官网入口网址:https://cloud.inspur.com/hairuo/cp/index.html
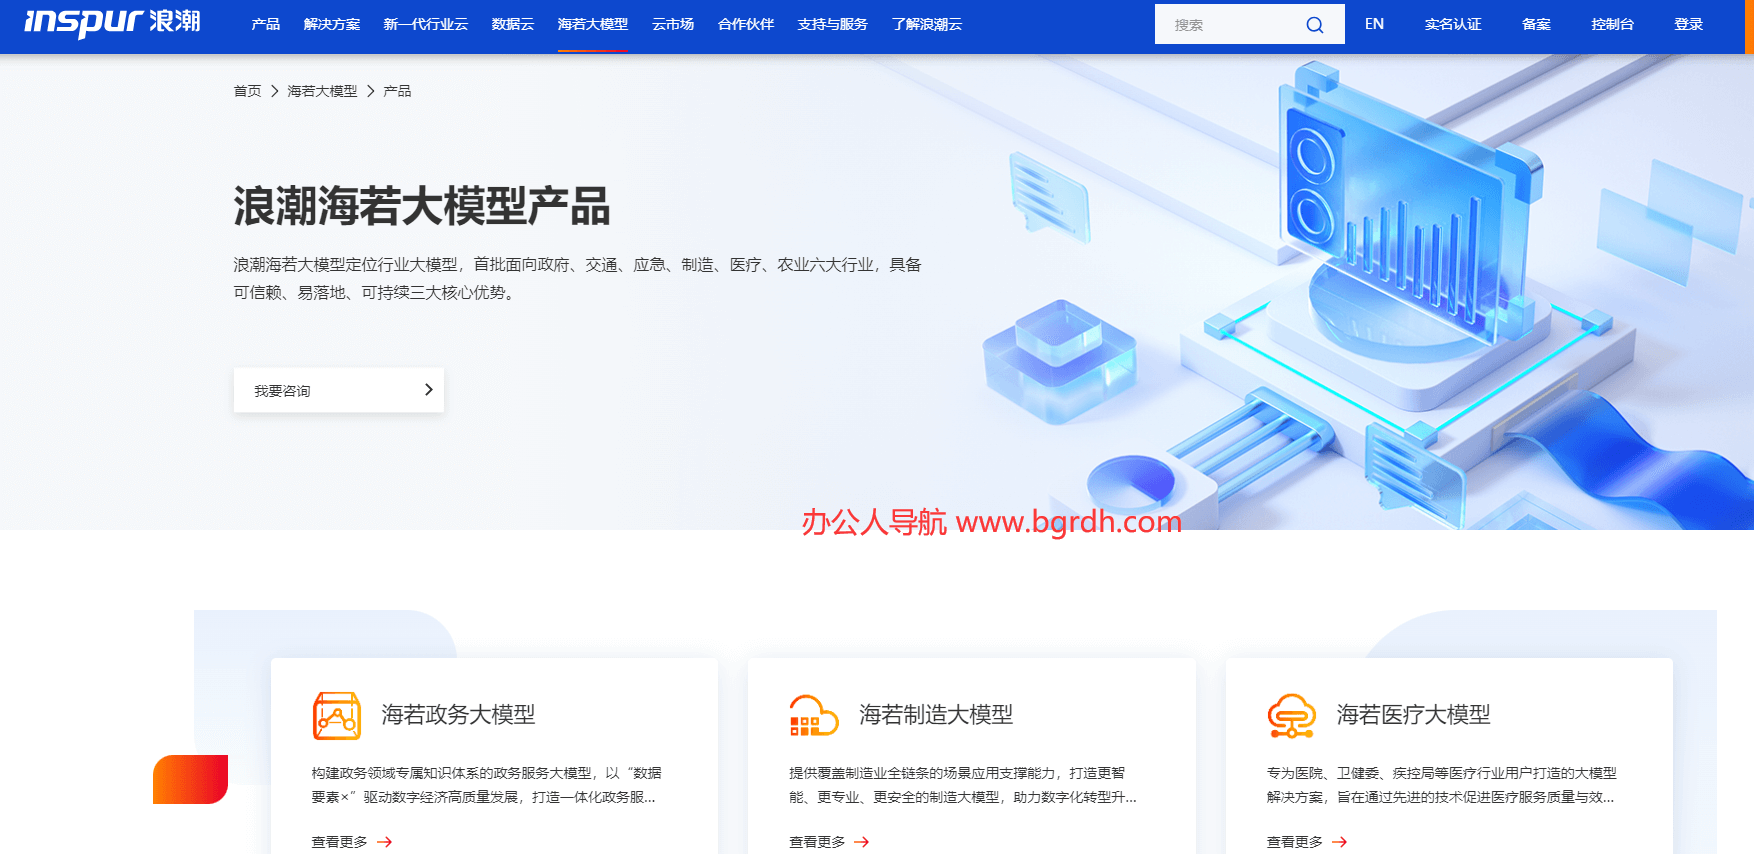
办公人导航bgrdh.com分享的浪潮海若大模型采用先进的技术架构,如MoE架构和全面优化的RAG,能够快速适配不同行业需求,同时兼顾模型的确定性和生成性。此外,浪潮云还为该模型构建了完整的产品体系,包括海若大模型平台、智能体工厂、智能体商店、模型开发平台和安全卫士等,以支持客户打造行业专属大模型。
浪潮海若大模型的核心优势在于“可信赖、易落地、可持续”,并依托浪潮云强大的算力基础设施和丰富的行业经验,推动各行业的数智化转型。例如,在医疗领域,浪潮海若大模型可以帮助医生快速生成病历;在农业领域,通过提升良品率和管理面积,显著提高生产效率。
浪潮云计划投入50亿元资金,加快推动海若大模型在100个城市的快速落地,并通过“海若三步法”(共建共赢、创新运营模式)实现行业应用。目前,浪潮海若大模型已在政务、制造、医疗等多个领域实现落地应用,并持续推动行业智能化发展。