0
VideoPoet 是由谷歌研究团队开发的一款创新的 AI 视频生成模型,旨在通过多模态大模型技术实现高质量视频内容的生成。该模型的核心优势在于其多模态大模型架构,能够处理和转换不同类型的输入信号,包括文本、图像、视频和音频,从而实现多种风格和动作的视频输出。
VideoPoet官网入口网址:https://sites.research.google/videopoet/
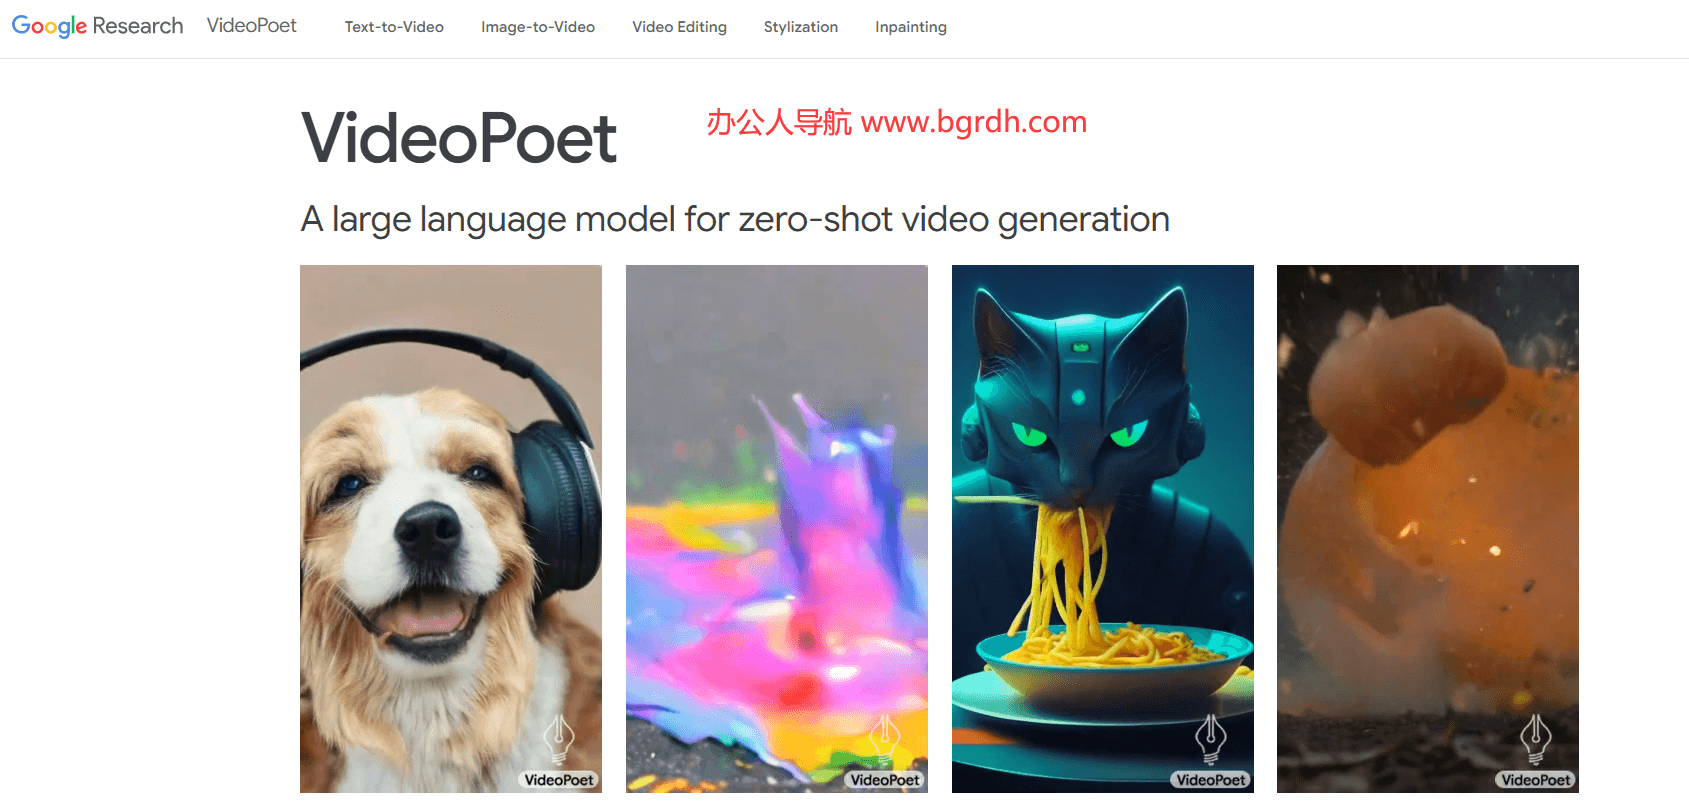
VideoPoet 的主要功能包括文本到视频、图像到视频、视频风格化、编辑与扩展、视频音频化和跨模态学习等。它采用仅解码器的 Transformer 架构,通过预训练和任务特定适应两个阶段进行训练。预训练阶段融合了多种多模态生成目标,使其能够应用于多种视频生成任务。此外,VideoPoet 还支持生成长达 10 秒的视频,并且无需特定数据集或扩散模型。
VideoPoet 的应用场景非常广泛,适用于电影制作、动画片、广告制作、虚拟现实等多个领域。用户只需输入文本描述,即可生成高质量的视频内容,无需视觉或音频指导。例如,谷歌团队曾利用 VideoPoet 根据文本提示生成了一段浣熊旅行的故事视频,总时长为 1 分钟。
VideoPoet 的官网地址为:https://sites.research.google.com/view/videopoet/ 。用户可以通过官网体验入口快速上手使用该工具,无论是行业专家还是初学者,都能轻松创作满足不同场景需求的视频内容。
VideoPoet 为视频创作提供了无限可能,无论是专业制作人还是普通爱好者,都能通过简单的操作实现创意表达。其强大的多模态处理能力和灵活的视频生成功能,使其成为未来 AI 视频生成技术的主流方向。