MMAudio 是一项由伊利诺伊大学厄巴纳-香槟分校、索尼人工智能和索尼集团等机构合作开发的前沿研究项目,其核心目标是通过多模态联合训练(Multimodal Joint Training)实现高质量的视频到音频合成(Video-to-Audio Synthesis)。该项目发表于CVPR 2025,标志着其在多模态学习和生成式AI领域的突破性进展。
- MMAudio官网入口网址:https://hkchengrex.com/MMAudio/
- MMAudio开源项目地址:https://github.com/hkchengrex/MMAudio
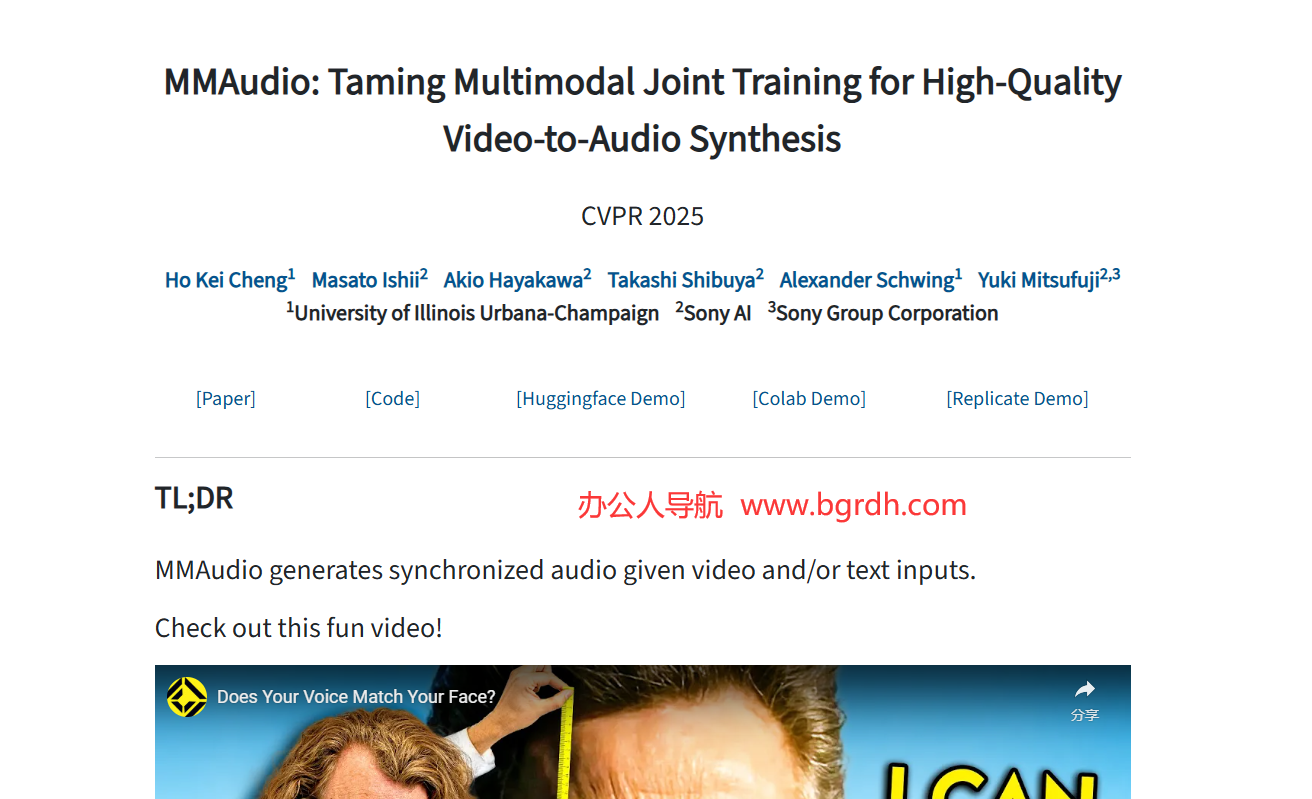
MMAudio 的核心创新在于其能够根据输入的视频和/或文本信息,生成与之同步的高质量音频输出。这一能力在多媒体内容生成、虚拟现实、影视制作、虚拟主播等领域具有广泛的应用前景。例如,用户可以通过输入一段视频或文本描述,系统即可自动生成与之匹配的音频内容,从而实现更自然、更真实的多媒体内容生成。
该项目不仅在技术上具有高度创新性,还提供了丰富的资源支持,包括论文、代码、Huggingface Demo、Colab Demo 和 Replicate Demo,方便研究人员和开发者快速上手和实验。此外,项目团队还提供了详细的论文和演示视频,便于用户深入了解其技术细节和应用场景。
MMAudio 代表了多模态学习和生成式AI领域的重要进展,为未来多媒体内容的生成和交互提供了新的可能性。