MiniMind 是一个开源的大语言模型(LLM)项目,旨在从零开始,以极低的成本(仅需3块钱)和极短的时间(2小时)训练出一个轻量级的语言模型。该项目由开发者 Jingyao Gong 发起,旨在降低大模型的学习门槛,让更多人能够从零开始训练和理解大模型的原理。
- MiniMind官网入口网址:https://jingyaogong.github.io/minimind/
- MiniMind开源项目地址:https://github.com/jingyaogong/minimind
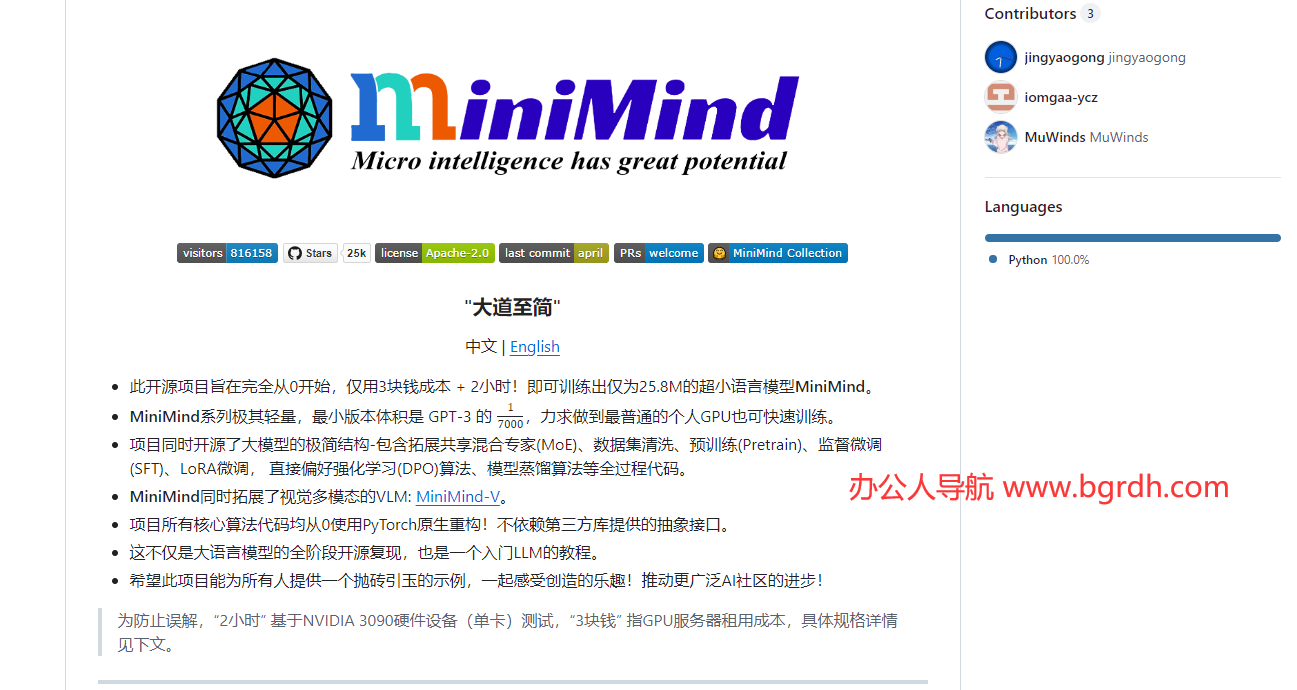
MiniMind 的核心特点是其极小的模型体积,最小模型体积仅为 GPT-3 的 1/7000,适合个人 GPU 快速训练。项目提供了完整的训练流程,包括预训练、监督微调(SFT)、LoRA 微调、强化学习(RLHF)等全过程代码,并且所有代码均从零开始用 PyTorch 重构,不依赖第三方库。
MiniMind 提供了多种模型版本,包括 MiniMind2 系列和 MiniMind-V(多模态扩展),支持多种训练和推理框架,如 llama.cpp、vllm、ollama 等。项目还提供了丰富的数据集和训练脚本,支持从零开始训练模型,并提供了详细的训练和评估工具。
MiniMind 的目标是推动 AI 社区的进步,让更多人能够理解和参与大模型的开发与训练。通过 MiniMind,用户可以体验从零开始训练一个语言模型的全过程,感受创造的乐趣。