Veo3
0

Veo3

Veo 3 是 Google DeepMind 推出的新一代视频生成模型,专为电影制作人、故事讲述者和创意工作者设计,将视频与音频无缝结合,开启生成式 AI 的创作新篇章。

链接直达

Veo3 是由 Google DeepMind 推出的新一代视频生成模型该模型能够通过文本或图像提示生成高质量、逼真的短视频,并且支持生成同步音频、背景音效和对话,从而提升视频的真实感和沉浸感。

Veo3官网入口网址:https://deepmind.google/models/veo/
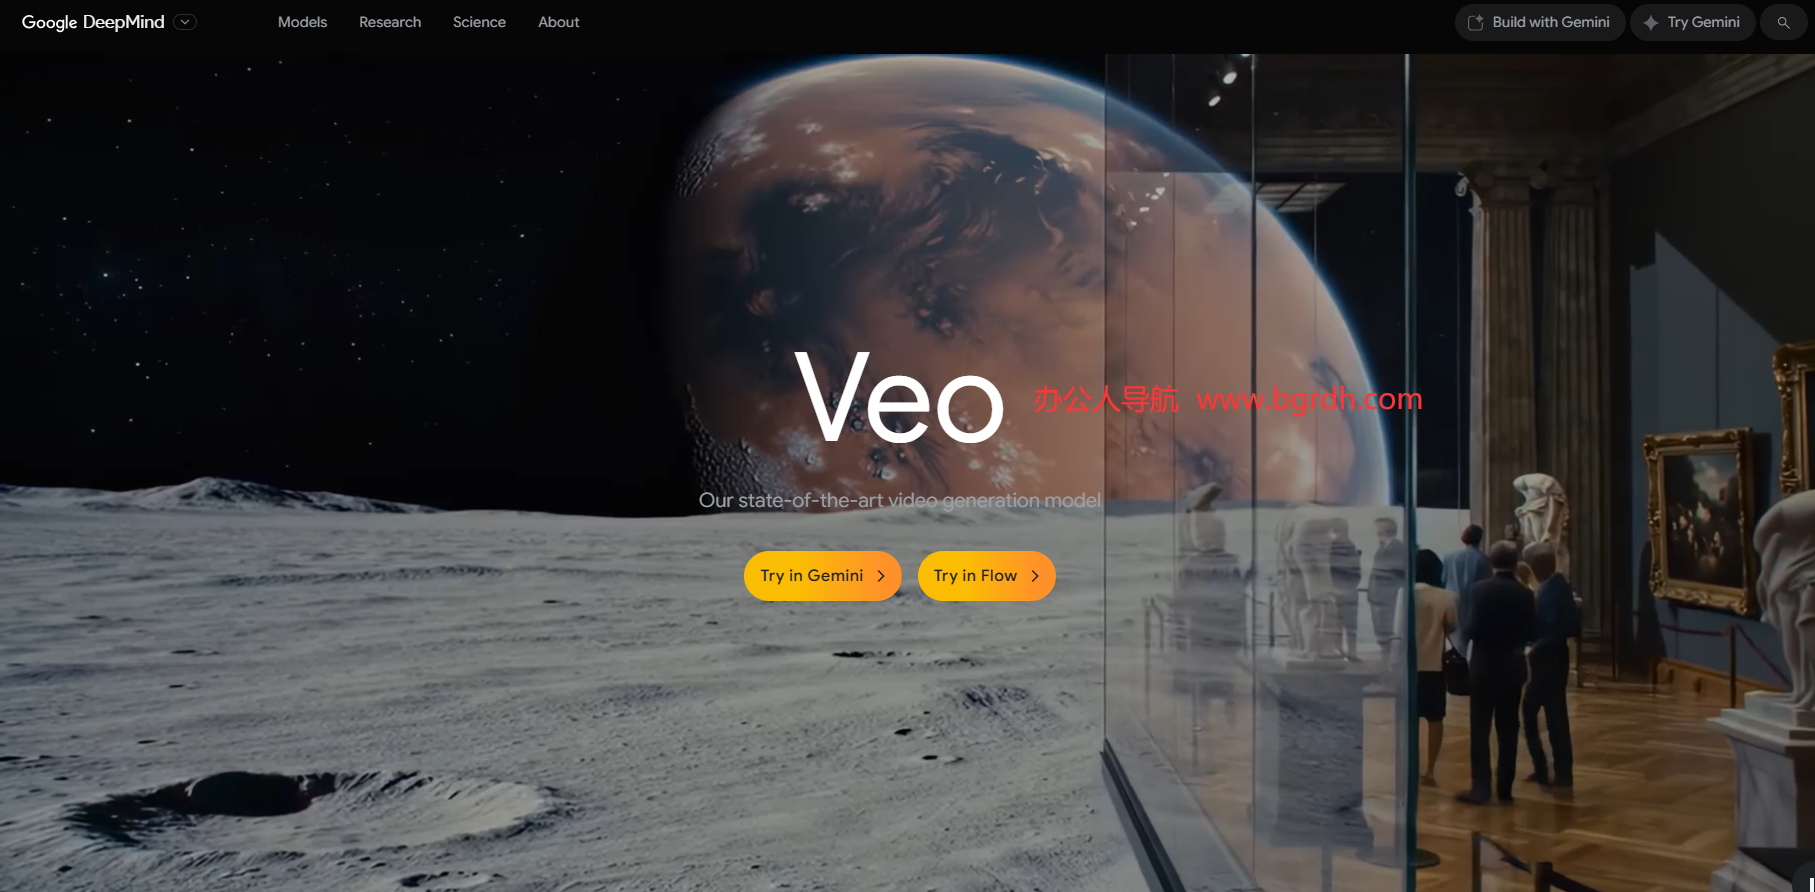
Veo3插图

Veo3 在多个方面实现了技术上的突破。例如,它在视频生成的真实感、物理模拟、唇形同步以及音频生成方面都有显著提升。此外,Veo3 能够处理复杂的提示,支持多元素输入,如摄像机参数、叙事对话和风格方向,从而实现更丰富的创作可能性。

Veo3 不仅提升了视频生成的效率和质量,还为影视、广告、教育等多个领域提供了新的创作工具。

Veo3 是 Google DeepMind 推出的新一代视频生成模型,它在视频生成技术上实现了多项突破,为视频创作和内容生成带来了新的可能性。

相关推荐

Grsai API

Grsai聚合了各种优秀的主流图片与视频生成大模型,以低于官网好几倍的价格为您降低使用成本!提供企业级专业稳定的API中转站,服务稳定可靠,达到99.99%。

LMArena

一个与人工智能(AI)模型评估和比较相关的平台,其核心功能是通过用户投票和社区参与的方式,对大型语言模型(LLM)进行评测和排名。

H

Hallo 是一个由复旦大学(Fudan University)开发的开源项目,专注于音频驱动的视觉合成技术,特别是用于人像动画生成。

M

MuseTalk 是一个实时高质量音频驱动唇形同步模型,旨在解决高分辨率、身份一致性和准确唇形同步的面部视觉配音挑战,尤其适用于实时应用如直播视频 。

S

SadTalker 是一个基于单张图像和音频生成说话人脸视频的模型,其核心功能是通过音频输入使静态图片中的图像动起来,并生成说话的虚拟人物。

评论

暂无评论,来抢沙发~