Z
0
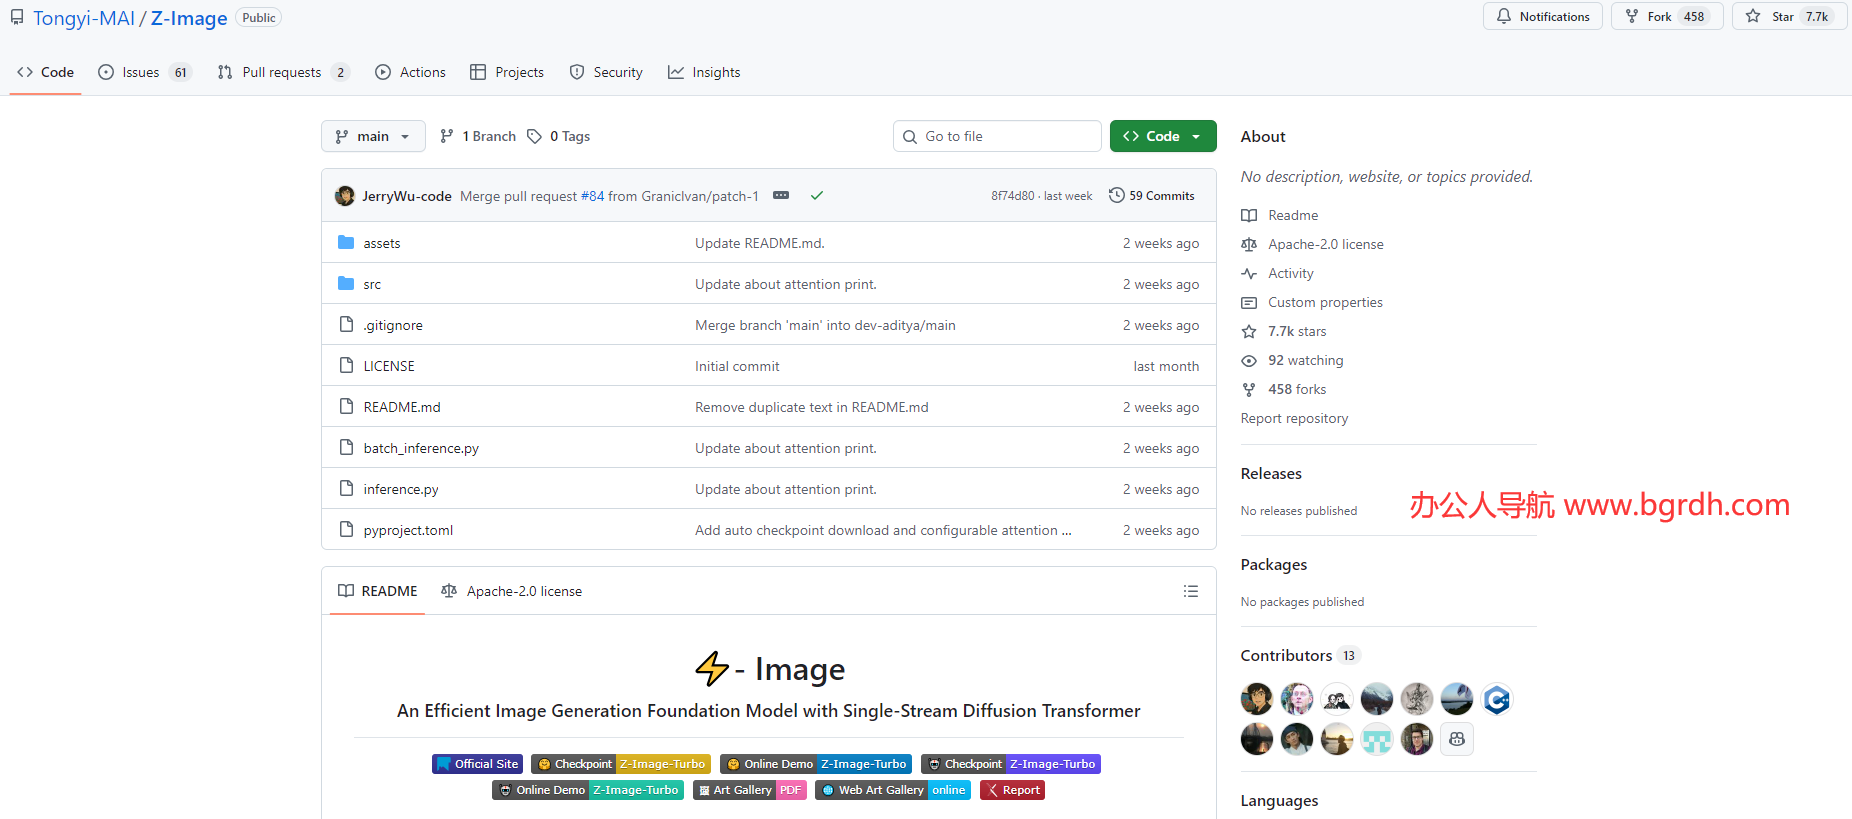
Z‑Image (造相)是阿里巴巴通义实验室(Tongyi‑MAI)在 2025 年开源的高效图像生成基础模型,代码托管在github。模型规模约 60 亿参数,采用 单流 Diffusion Transformer(DiT) 架构,将文本理解与图像生成统一在同一网络中,实现了“思考‑生成”一体化的工作流。
- Z-Image开源项目官网入口网址:https://github.com/Tongyi-MAI/Z-Image
- modelscope网址:https://www.modelscope.cn/models/Tongyi-MAI/Z-Image-Turbo
- Hugging Face网址:https://huggingface.co/Tongyi-MAI/Z-Image-Turbo
通过 Decoupled‑DMD(Distribution Matching Distillation) 技术,Z‑Image‑Turbo 版本在仅 8 步(8 NFE) 推理下即可生成高质量、逼真的照片级图像,推理时间常在亚秒级,显著优于同类大模型。模型特别擅长 中英文双语文本渲染,能够在图像中准确呈现复杂的中文字符,这在开源图像生成模型中极为罕见。
Z‑Image 提供了多种变体:
- Z‑Image‑Base:原始基线模型,适合研究与二次开发;
- Z‑Image‑Turbo:轻量蒸馏版,兼顾速度与质量,适合商业化部署;
- Z‑Image‑Edit:支持图像编辑与局部修改的扩展模型。
项目配套了官方文档、在线 Demo(Hugging Face、ModelScope) 以及 托管 API 服务,用户只需几行代码即可调用模型生成图像,广泛用于创意设计、内容创作、营销素材、电子商务摄影等场景。
Z‑Image 通过参数压缩与架构创新,实现了 高效、低成本、易部署 的图像生成解决方案,既满足科研实验的可复现需求,也为企业级应用提供了快速、可靠的视觉内容生产工具。